ResearchPublications & labs
I’m broadly interested in 3D reconstruction, diffusion-based generative models, video synthesis, and efficient learning — especially generative systems that are semantically meaningful and computationally efficient on complex spatial and temporal data.
Publications
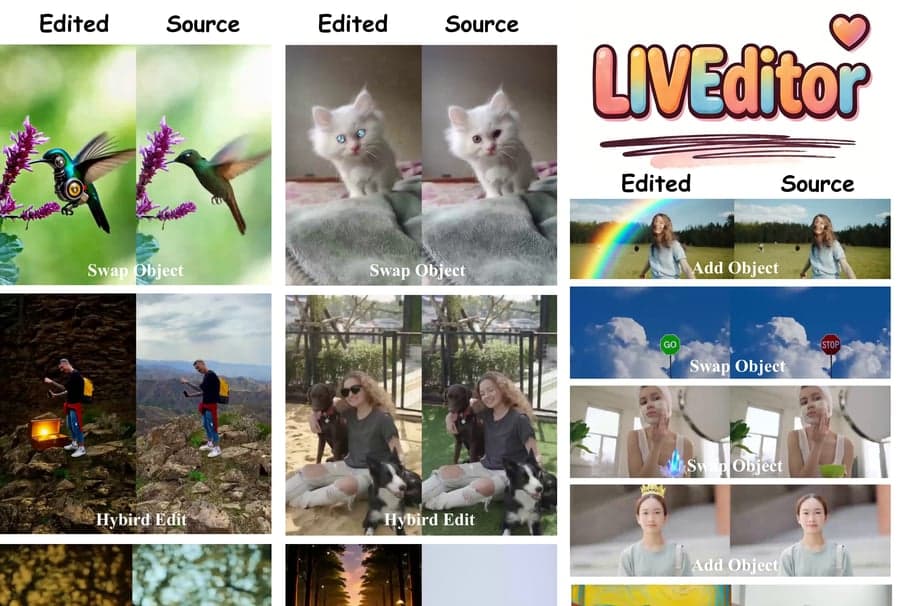
LIVEditor-14B: Lightning Unified Video Editing via In-Context Sparse Attention
ICML 2026Accepted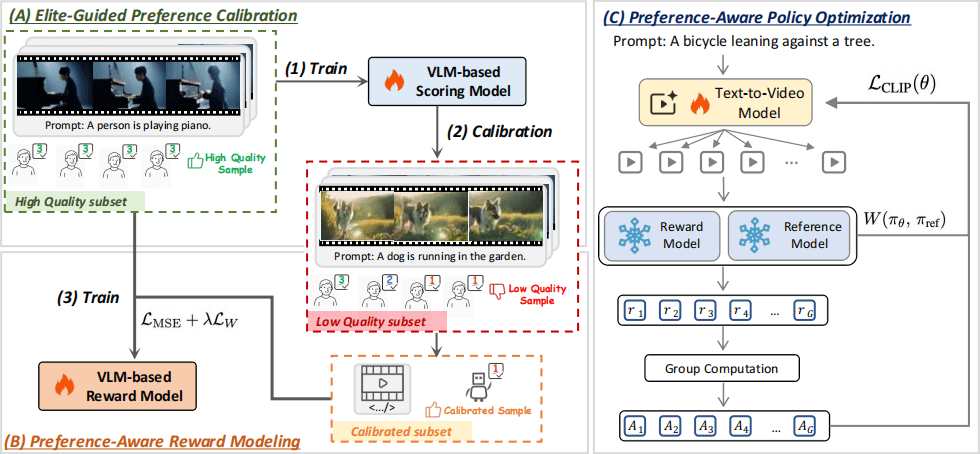
AgentShot: Towards Agentic Multi-Shot Video Generation and Benchmarking
AAAI 2027Under reviewHVCap: Human-centric Video Captioning via Factorized GRPO and a New Benchmark
ACM MM 2026Under review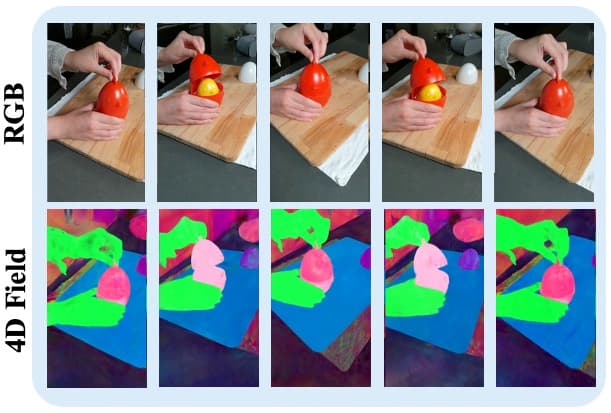
4D LangSplat: 4D Language Gaussian Splatting via Multimodal Large Language Models
CVPR 2025Accepted
Labs
Harvard Visual Computing Lab
Research Assistant · Research
Worked with Prof. Hanspeter Pfister and Dr. Wanhua Li on 4D LangSplat, bringing language fields into dynamic 3D Gaussian splatting (CVPR 2025).
Brown Visual Computing Lab
Research Assistant · Research
Monocular dynamic scene decomposition (an extension of SAFF) with self-supervised vision transformer features.
University of Wisconsin–Madison
Research Assistant · Research
Undergraduate research across robotics control, computational imaging, and autonomous-driving simulation.